要能够解答以下问题
1、为何索引叫key
2、索引是如何加速查询的,它的原理是什么
索引模型/结构从二叉树-->B树--->B+树,每种树到底有什么问题最终演变成了B+树
3、为何B+树不仅能够加速等值查询,还能加速范围查询
4、什么是聚集索引,什么是辅助索引
5、什么情况下叫覆盖了索引
6、什么情况下叫回表操作
7、什么是联合索引,最左前缀匹配原则
8、索引下推,查询优化
9、如何正确使用索引一 索引介绍
1.1 索引的概念
索引是存储引擎中一种数据结构,或者说数据的组织方式,又称之为键key,是存储引擎用于快速找到记录的一种数据结构
表中的一行行数据按照索引规定的结构组织成了一种树形结构,该数叫B+树
1.2 索引的作用
通常情况下,应用系统的读写比例在10:1左右,而且插入操作和一般的更新操作很少出现性能问题,在生产环境中,我们遇到最多的、也是最容易出问题的,还是一些复杂的查询操作,因此对查询语句的优化是重中之重,而索引可以加速查询。
索引优化应该是对查询性能优化最有效的手段,索引能够轻易将查询性能提高好几个数量级
1.3 如何正确的看待索引
1、软件上线之后,运行了一段时间,发现软件运行极卡,想到要加索引,这时候火烧眉毛了再想着加索引,光把问题定位到索引身上就需要耗费很长时间,排查成本高
最好是在软件开发之初配合开发人员,定位到常用的查询字段,然后为该字段提前创建索引

2、索引并非越多越好,索引是用于加速查询的,降低写效率,如果某一张表的ibd文件中创建了很多颗索引树,意味着很小一个update语句就会导致很多颗索引树都需要发生变化,从而把硬盘io打上去
1.4 如何正确的使用索引
1、以什么字段的值为基础构建索引?
最好是不为空、唯一、占用空间小的字段

2、针对全表查询语句如何优化?
应用场景:用户想要浏览所有的商品信息
select count(id) from s1;
如何优化?---->开发层面分页查找,用户每次看现场从数据中拿

3、针对等值查询
以查询字段为基础创建索引?
select count(id) from s1 where id=33;
(1)以重复度低的字段为基础创建索引加速效果明显
(2)以重复度高字段为基础创建索引加速效果差
(3)以占用空间大的字段为基础创建索引加速效果差

4、关于范围查询
(1)InnoDB存储能加速范围查询,但是查询范围不能特别大
(2)
> >=
< <=
!=
between and
like 后的内容应该往右放,并且左半部分的内容应该尽量精确

5、关于条件字段参与运算
不要让条件字段参与运算,或者说传递给函数


-----------------------------------------------
总结:
给重复低、且占用空间小的字段值为基础构建索引
1.5 储备知识
1、索引根本原理就是把硬盘io次数降下来,为一张表中的一行行记录创建索引就好比书的一页页内容常见目录,有了目录结构之后,我们以后的查询都应该通过目录去查询

2、一次磁盘io带来的影响(机械硬盘)
7200转/分钟------->120转/s
一次io的延迟时间=平均寻道时间(5ms)+平均延迟时间(4ms)--->9ms
这对于计算机来说,是极大的延迟,通常这一次io查询就能执行450万条指令

3、磁盘预读
innodb存储引擎一页16k,即一次io读16K到内存中
一页就是一个磁盘块
# 考虑到磁盘io是非常高昂的计算操作,计算机操作系统做了一些优化
当进行一次io时,不光把当前磁盘地址的数据,而是把相邻的数据也都读取到内存缓冲区内,因为局部预读性原理告诉我们,当计算机访问一个地址都数据的时候,与其相邻的数据也会很快被访问到。
二 索引的分类(了解,主要学习B+树)
1、索引模型分为很多种类
#===========B+树索引(等值查询与范围查询都快)
二叉树->平衡二叉树->B树->B+树

#===========HASH索引(等值查询快,范围查询慢)
将数据打散再去查询
innodb引擎软件的内部逻辑有使用,在内存部分

#===========FULLTEXT:全文索引
通过关键字的匹配来进行查询,类似于like的模糊匹配
like + %在文本比较少时是合适的
但是对于大量的文本数据检索会非常的慢
全文索引在大量的数据面前能比like快得多,但是准确度很低
百度在搜索文章的时候使用的就是全文索引,但更有可能是ES
2、不同的存储引擎支持的索引种类也不一样
InnoDB存储引擎
支持事务,支持行级别锁定,支持 B-tree(默认)、Full-text 等索引,不支持 Hash 索引;

MylSAM存储引擎
不支持事务,支持表级别锁定,支持 B-tree、Full-text 等索引,不支持 Hash 索引;

Memory存储引擎

不支持事务,支持表级别锁定,支持 B-tree、Hash 等索引,不支持 Full-text 索引;

--------------------------------------------------------
因为mysql默认的存储引擎就是innodb,而innodb存储引擎的索引模型/结构是B+树,所以我们着重学习B+树
三 索引的数据结构
3.1 创建索引的两大步骤
1、提取每行记录中该字段的值,以该值当做key,至于key对应对value是什么?每种索引结构各不相同
2、以key值为基础构建索引结构,以后的查询条件中使用了该字段,则会命中索引结构
# 1、为user表的id字段创建索引,会以每条记录的id字段值为基础生成索引结构
create index 索引名 on user(id);
使用索引
select * from user where id = xxx;

# 2、为user表的name字段创建索引,会以每条记录的name字段值为基础生成索引结构
create index 索引名 on user(id);
使用索引
select * from user where name = xxx;
3.2 二叉查找树
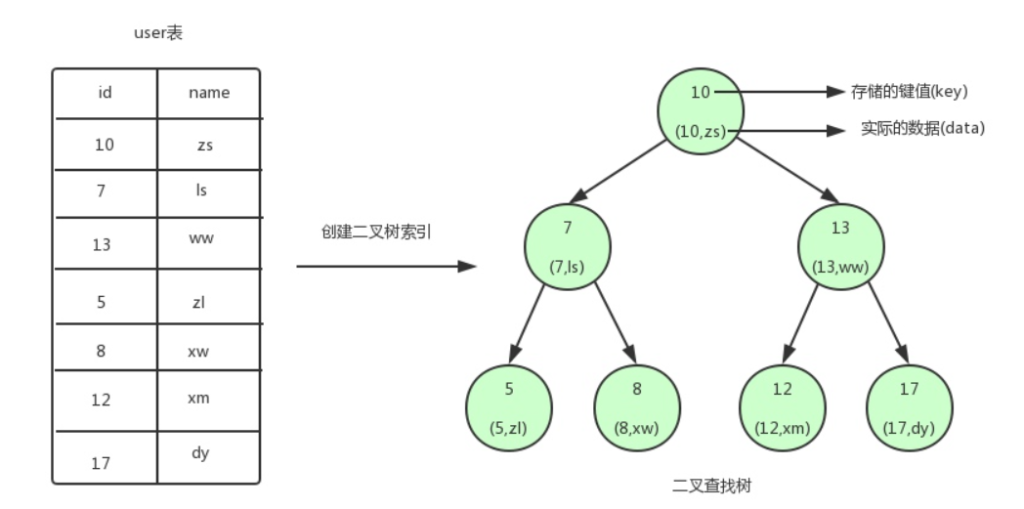
有user表,我们以id字段值为基础创建索引,以key值的大小为基础构建二叉树,如上图所示
1、二叉树的特点
1、任何节点的左子节点的键值都小于当前节点的键值,右子节点的键值都大于当前节点的键值。
2、顶端的节点我们称为根节点,没有子节点的节点我们称之为叶节点。
2、利用我们创建的二叉树索引,查找流程如下
如果我们要查找id=12的用户信息

1、将根节点作为当前节点,把12与当前节点的键值10比较,12大于10,接下来我们把当前节点>的右子节点作为当前节点。

2、继续把12和当前节点的键值13比较,发现12小于13,把当前节点的左子节点作为当前节点。

3、把12和当前节点的键值12对比,12等于12,满足条件,我们从当前节点中取出data,即id=1>2,name=xm。
利用二叉查找树我们只需要三次即可找到匹配的数据,如果是在表中一条条的查找到话,我们需要6次才能找到
3.3 平衡二叉树
基于3.1展示的二叉树,我们确实可以快速找到数据,但是根据二叉树的特点,二叉树也可以是如下的构造
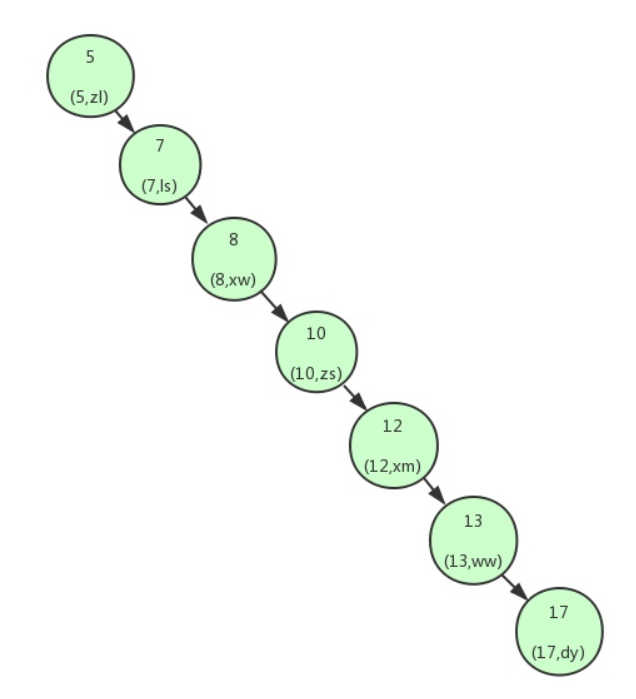
这时候二叉查找树就变成了一个链表,这导致查找效率不稳定,因此就需要用到平衡二叉树了
平衡二叉树有称之为AVL树,在满足二叉查找树都基础上,要求每个节点的左右子树都高度不能超过1,下面是平衡二叉树和非平衡二叉树的对比
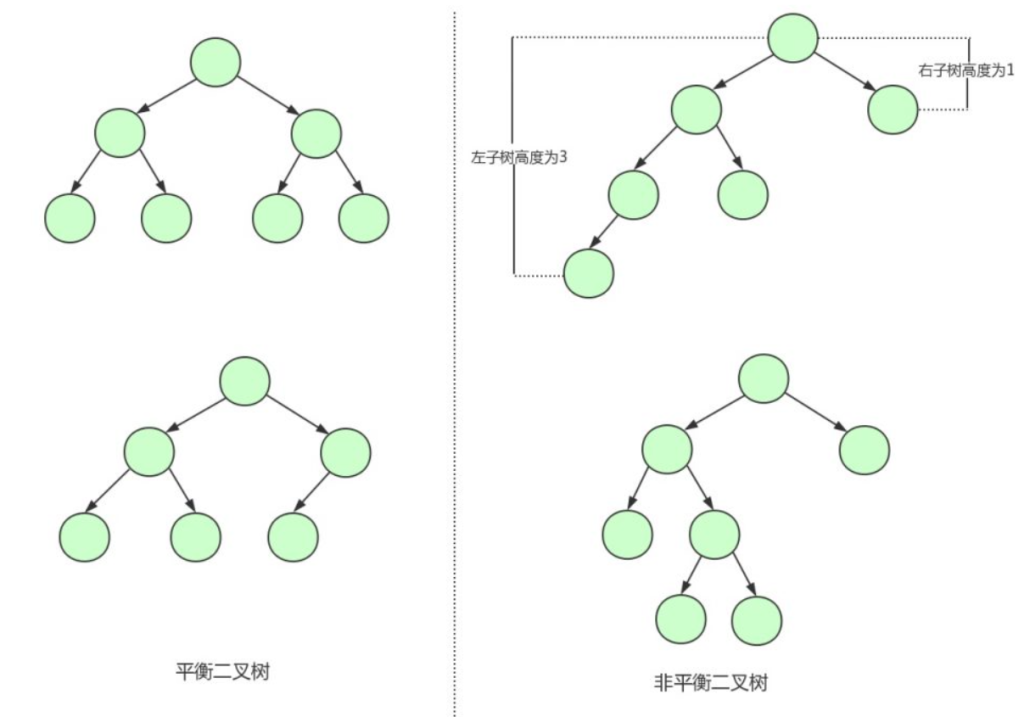
平衡二叉树相比于二叉查找树来说,查找效率更稳定,总体的查找速度也更快
3.4 B树
1、B树出现的原因
平衡二叉树这种数据结构每个磁盘块只能放一个节点,每个节点只能存放一组键值对,此时如果数据量过大,二叉树都节点则会非常多,树的高度也随机变高,这会导致数据的查找次数变多,查找数据的效率变的极低

1、为了减少从磁盘读取数据的次数
2、如果能够把尽量多的数据放进磁盘块中,那一次磁盘读取操作就会读取更多数据,那我们查找数据的时间也会大幅度降低
综上所述,如果我们能够在平衡二叉树的基础上,把更多的节点放入一个磁盘块中,那么平衡二叉树的弊端就解决了,这就是构建了一个单节点也可以存储多个键值对的平衡树,也就是B树
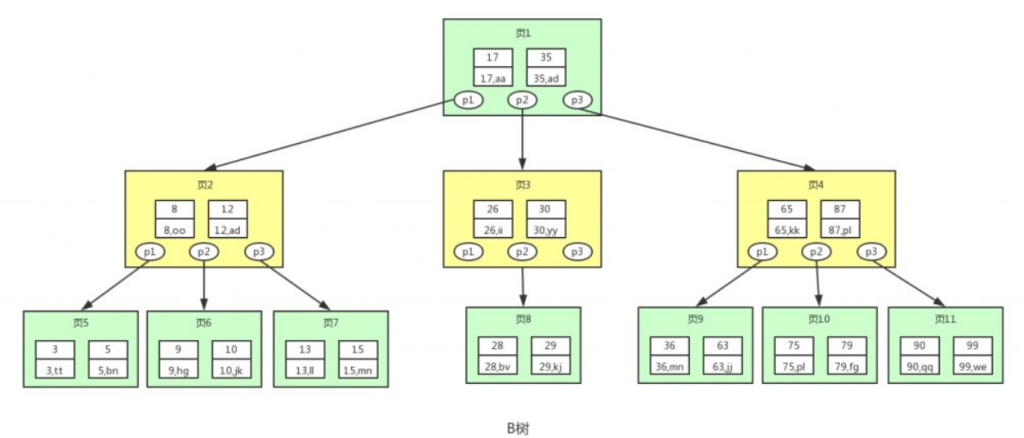
2、B树(Balance Tree)即为平衡树都意思,下图即是一颗B树
注意:
1、图中的P节点为指向子节点的指针,二叉查找树和平衡二叉树内也有,只是图中省略了
2、图中的每个节点都放了很多的键值对,一个节点也称之为一页,一页即一个磁盘块,在mysql中数据读取的基本单位都是页,即一次io读取一个页的数据,所以我们这里叫做页更符合mysql中索引的底层数据结构
从上图可以看出,B树相对于平衡二叉树,每个节点存储了更多的键值和数据,并且每个节点也拥有了更多的子节点,子节点的个数一般称之为阶,上图就是三阶B树,高度也会很低
3、B树都查找流程
假如我们要查找id=28的用户信息
1、先找到根节点也就是页1,判断28在键值17和35之间,我们那么我们根据页1中的指针p2找到页3
2、将28和页3中的键值相比较,28在26和30之间,我们根据页3中的指针p2找到页8
3、将28和页8中的键值相比较,发现有匹配的键值28,键值28对应的用户信息为(28,bv)
3.5 B+树
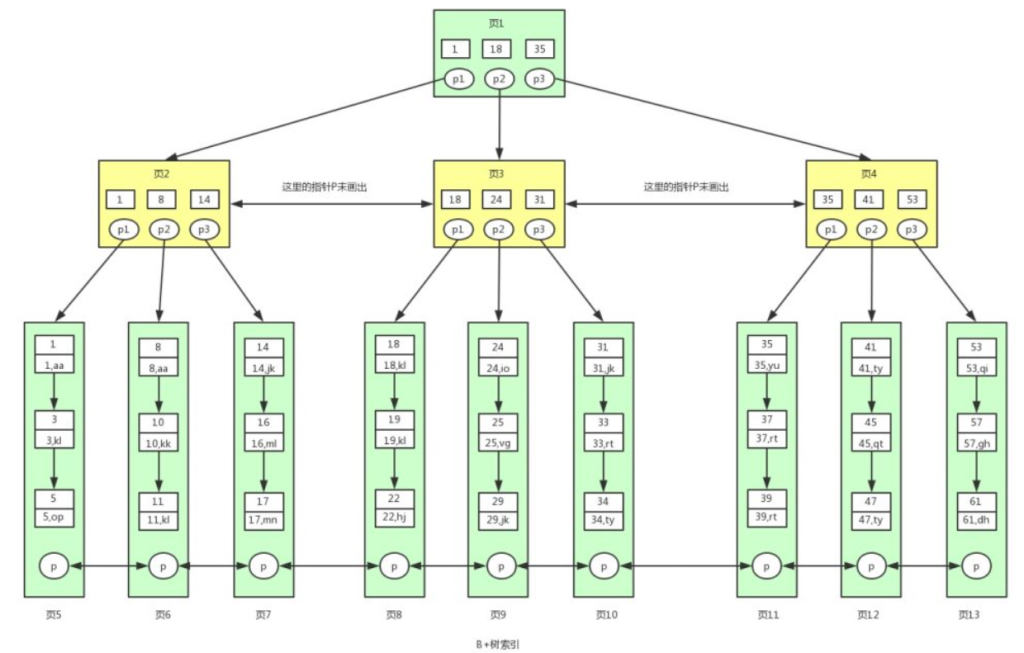
B+树相对与B树,做了更多的优化
1、B+树非叶子节点non-leaf node上是不存储数据的,仅存储键,而B树的非叶子节点中不仅存储键,也会存储数据。B+树之所以这么做的意义在于:树一个节点就是一个页,而数据库中页的大小是固定的,innodb存储引擎默认一页为16KB,所以在页大小固定的前提下,能往一个页中放入更多的节点,相应的树的阶数(节点的子节点树)就会更大,那么树的高度必然更矮更胖,如此一来我们查找数据进行磁盘的IO次数会有再次减少,数据查询的效率也会更快。

2、B+树的阶数是等于键的数量的,例如上图,我们的B+树中每个节点可以存储3个键,3层B+树可以存储3*3*3=9个数据。所以如果我们的B+树一个节点可以存储1000个键值,那么3层B+树可以存储1000*1000*1000=10亿个数据。而一般根节点是常驻内存的,所以一般我们查找10亿数据,只需要2次磁盘IO,真是屌炸天的事。

3、因为B+树索引的所有数据均存储在叶子节点leaf node,而且数据是按照顺序排列的。那么B+树使得范围查找、排序查找、分组查找以及去重查找变得异常简单。而B树因为数据分散在各个节点,要实现这一点是很不容易的。

而且B+树中各个页之间也是通过双向链表连接的,叶子节点中的数据是通过单向链表连接的。其实上面的B树我们也可以对各个节点加上链表。其实这些不是它们之前的区别,是因为在mysql的innodb存储引擎中,索引就是这样存储的。也就是说上图中的B+树索引就是innodb中B+树索引真正的实现方式,准确的说应该是聚集索引。

通过上图可以看到,在innodb中,我们通过数据页之间通过双向链表链接以及叶子节点中数据之间通过单向链表连接的方式可以找到表中的所有数据
四 聚集索引与非聚集索引
4.1 聚集索引
聚集索引、聚簇索引、主键索引:以主键字段值为key构建的B+树,该B+树都叶子节点放的是主键值与本行完整的记录
即:表中的数据都聚集在叶子节点,所以称之为聚集索引
select * from user where id=2;
4.2 非聚集索引
非聚集索引、非聚簇索引、辅助索引、二级索引:以非主键字段值为key构建的B+树,该B+树都叶子节点存放的是key与其对应的主键字段值
create index yyy on user(name);
select * from user where name="xxx";
注意:一张innodb存储引擎表中必须要有且只能有一个聚集索引,但是可以多个辅助索引
五 覆盖索引、回表操作
5.1 回表操作
概念:在命中辅助索引的基础上,在辅助索引的叶子节点并没有找到想要的数据,需要拿着对应的主键字段值去聚集索引里再找一下
主键索引--->id字段
辅助索引--->name字段
select name.age,gender from user where name='egon';
5.2 覆盖索引
概念:在命中索引的基础上,只在本索引的叶子节点就找到了我们想要的数据
主键索引--->id字段
辅助索引--->name字段
select id,name from user where name='egon';
六 索引管理
6.1 B+树索引的分类
1、聚集索引:即主键索引,primary key
用途:
加速查询
约束(不为空,不能重复)
2、唯一索引:unique
用途:
加速查找
约束(不能重复)
3、普通索引index:
用途:
加速查找
4、联合索引:
primary key(id,name):联合主键索引
unique(id,name):联合唯一索引
index(id,name):联合普通索引
6.2创建主键索引
1、创建表后再加主键创建索引(公司不会用)
# 创建主键索引
alter table student add primary key t1(id);
alter table student drop primary key;
# 创建唯一索引
alter table country add unique key uni_name(name);
alter tabke t1 drop index t1;
2、创建普通索引
create table t1(
    id int primary key auto_increment,
    class_name varchar(10) unique,
    name varchar(16),
    age int
);

create index xxx on t1(name);
drop index xxx on t1;
七 联合索引与最左前缀匹配原则
如果创建的索引是一个联合索引——id,name,age
create index zz on t1(id,name,age);
查询条件中会出现
id name age
id name
id age
id

假如表内有这四条数据
1,egon1,18,male,egon@qq.com
2,egon2,28,male,egon@qq.com
3,egon3,38,female,egon@qq.com
4,egon4,48,male,egon@qq.com
5,egon5,58,male,egon@qq.com

比较大小
1,egon1,18
2,egon,28
先比较id的大小,如果没比较出来再比较name,如果也没比较出来,那么最后比较age

什么时候创建联合索引?
条件中需要用到多个字段,并且多次查询中的多个字段都包含某一个字段

需要注意的问题:重复度低且占用空间较小的字段应该尽量往左放,让其成为最左前缀,比较类型必须保持一致,例如id=10.不要id='10'
八 索引下推技术
对于连续多个and的条件,mysql的优化器会分析出多条执行方案,选取最优待一种,即先找到某一个条件把范围缩小
eg:
select count(id) from s1 where name="egon" and email="egon3@oldboy" and gender="male";
根据这条命令,innodb存储引擎会去寻找这三个条件中查询最快的方案,例如如果name没有建立索引,那么会看看email有没有建立索引,如果也没有,最后会去看看gender有没有建立索引

总结:
1、and连接的多个条件,锁定的是一个小范围,mysql的优化器会从and条件中选取一个最精确的来优先缩小范围
2、or连接的多个条件,锁定的是一个很大的范围,mysql优化没办法了,只能从左到右依次判断条件
实验一 创建索引测试
1、创建表s1
mysql> create table s1(
    -> id int,
    -> name varchar(20),
    -> gender char(6),
    -> email varchar(50),
    -> );
2、创建存储过程
[root@localhost test]# ls -la
总用量 4
drwxr-xr-x.  2 root  root   22 9月   3 10:15 .
dr-xr-xr-x. 20 root  root  280 8月  12 17:46 ..
-rwxr-xr-x   1 mysql mysql 252 9月   3 10:15 init.sql

[root@localhost test]# cat init.sql
delimiter $$
create procedure auto_insert1()
BEGIN
  declare i int default 1;
  while(i<3000000)do
    insert into s1 values(i,'egon','male',concat('egon',i,'@oldboy'));
    set i=i+1;
    select concat('egon',i,'_ok');
  end while;
END$$
delimiter ;
3、导入数据库并查看存储过程和调用存储过程
mysql> source /test/init.sql
Query OK, 0 rows affected (0.05 sec)

mysql> show create procedure auto_insert1G
*************************** 1. row ***************************
           Procedure: auto_insert1
            sql_mode: ONLY_FULL_GROUP_BY,STRICT_TRANS_TABLES,NO_ZERO_IN_DATE,NO_ZERO_DATE,ERROR_FOR_DIVISION_BY_ZERO,NO_AUTO_CREATE_USER,NO_ENGINE_SUBSTITUTION
    Create Procedure: CREATE DEFINER=`root`@`localhost` PROCEDURE `auto_insert1`()
BEGIN
  declare i int default 1;
  while(i<3000000)do
    insert into s1 values(i,'egon','male',concat('egon',i,'@oldboy'));
    set i=i+1;
    select concat('egon',i,'_ok');
  end while;
END
character_set_client: utf8mb4
collation_connection: utf8mb4_unicode_ci
  Database Collation: utf8mb4_unicode_ci
1 row in set (0.00 sec)

mysql> call auto_insert1();
4、查看id总数是否正确,然后在现在无索引的情况下查看id=33的那一行记录所用的时间
mysql> select count(id) from s1;
+-----------+
| count(id) |
+-----------+
|   2999999 |
+-----------+
1 row in set (0.89 sec)

mysql> select * from s1 where id=33;
+------+------+--------+---------------+
| id   | name | gender | email         |
+------+------+--------+---------------+
|   33 | egon | male   | egon33@oldboy |
+------+------+--------+---------------+
1 row in set (0.87 sec)
5、用id创建索引后查询id=33记录的速度
mysql> create index xxx on s1(id);
Query OK, 0 rows affected (2.66 sec)
Records: 0  Duplicates: 0  Warnings: 0

mysql> select * from s1 where id=33;
+------+------+--------+---------------+
| id   | name | gender | email         |
+------+------+--------+---------------+
|   33 | egon | male   | egon33@oldboy |
+------+------+--------+---------------+
1 row in set (0.00 sec)